Milestone 1: Thu thập dữ liệu (25.000 bài báo)

Milestone 1: Thu thập dữ liệu (25.000 bài báo)#

Mục tiêu và quy mô toàn nhóm#

Milestone 1 thu thập metadata theo từng paper (đơn vị thống kê citation/metadata), mã nguồn LaTeX/BibTeX/BBL theo từng (paper, version) (đơn vị tải nguồn và audit), cùng mạng lưới trích dẫn từ Semantic Scholar cho toàn bộ 25.000 arXiv ID của 5 thành viên (5.000 bài/thành viên).

Trước khi chạy Milestone 2, thành viên TRI (24120470) vốn mới có 4.425/5.000 bài do hết ngân sách thời gian 11,5 giờ ở lần crawl trước đã được chạy tiếp --resume hoàn toàn trên Google Colab CPU-only, kéo đủ 5.000/5.000 bài và xác minh 8.338/8.338 version nguồn.

Hide code cell source

from pathlib import Path
import json
import pandas as pd
import matplotlib.pyplot as plt
from IPython.display import display, Markdown
data = json.loads((Path.cwd().parent / 'report_summary.json').read_text(encoding='utf-8'))
scope, m1, m2, bench = data['scope'], data['m1'], data['m2'], data['m2_benchmark']
plt.rcParams.update({'figure.figsize': (9.2, 4.2), 'axes.spines.top': False, 'axes.spines.right': False, 'figure.dpi': 120})
print(f"Toàn nhóm (5 thành viên): {scope['papers']:,} paper / {scope['versions']:,} version | Cập nhật: {data['report_date']}")
Toàn nhóm (5 thành viên): 25,000 paper / 41,498 version | Cập nhật: 2026-11-22

Hide code cell source

display(Markdown('**Bảng M1.1. Tổng quan corpus hợp nhất 5 thành viên sau khử trùng.**'))
display(pd.DataFrame([
    ('Tổng ID được giao (5 thành viên)', scope['group_assigned'], 'paper'),
    ('Số publication hợp nhất (0 trùng lặp)', scope['papers'], 'paper'),
    ('Tổng số version ghi nhận', scope['versions'], 'version'),
    ('Chuỗi archive backup đã xác minh SHA-256', scope['archives_used'], 'archive'),
    ('Working references (0 mồ côi)', m1['working_reference_rows'], 'cạnh trích dẫn'),
    ('Course export references (có đích arXiv)', m1['arxiv_reference_rows'], 'cạnh trích dẫn'),
], columns=['Chỉ tiêu', 'Số lượng', 'Đơn vị']))

Bảng M1.1. Tổng quan corpus hợp nhất 5 thành viên sau khử trùng.

Chỉ tiêu Số lượng Đơn vị
0 Tổng ID được giao (5 thành viên) 25000 paper
1 Số publication hợp nhất (0 trùng lặp) 25000 paper
2 Tổng số version ghi nhận 41498 version
3 Chuỗi archive backup đã xác minh SHA-256 1713 archive
4 Working references (0 mồ côi) 976351 cạnh trích dẫn
5 Course export references (có đích arXiv) 456149 cạnh trích dẫn

Hide code cell source

sa = m1['source_audit']
metrics = pd.DataFrame([
    ('Version có TeX đã xác minh', sa.get('tex_verified', 0), scope['versions']),
    ('Version xác minh hợp lệ (gồm empty PDF-only/no-LaTeX)', m1['source_verified'], scope['versions']),
    ('Paper đủ 100% version nguồn xác minh', m1['papers_with_all_sources_verified'], scope['papers']),
    ('Paper có kết quả S2 (success hoặc empty xác nhận)', m1['verified_reference_papers'], scope['papers']),
    ('Paper đủ cả nguồn xác minh lẫn S2', m1['papers_with_sources_and_s2_verified'], scope['papers']),
], columns=['Chỉ tiêu', 'Đạt', 'Mẫu số'])
metrics['Tỷ lệ (%)'] = (100 * metrics['Đạt'] / metrics['Mẫu số']).round(2)
display(Markdown('**Bảng M1.2. Độ phủ nguồn và references trên toàn bộ 25.000 bài.**'))
display(metrics)
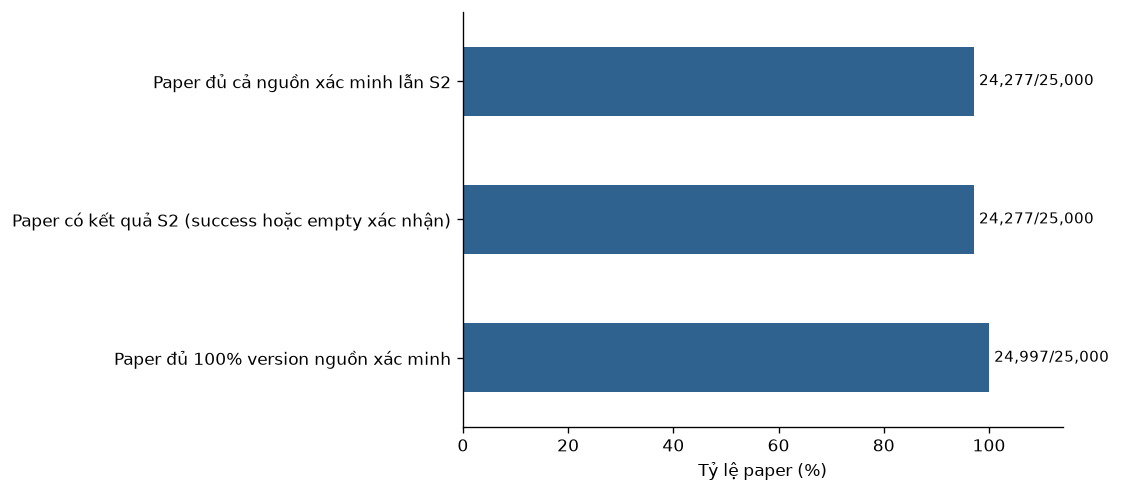
plot = metrics.iloc[2:].copy()
ax = plot.plot.barh(x='Chỉ tiêu', y='Tỷ lệ (%)', legend=False, xlim=(0, 114), color='#2f628e')
for i, row in enumerate(plot.to_dict('records')):
    ax.text(row['Tỷ lệ (%)'] + 1, i, f"{row['Đạt']:,}/{row['Mẫu số']:,}", va='center', fontsize=9)
ax.set_xlabel('Tỷ lệ paper (%)'); ax.set_ylabel('')
plt.tight_layout(); plt.show()

Bảng M1.2. Độ phủ nguồn và references trên toàn bộ 25.000 bài.

Chỉ tiêu Đạt Mẫu số Tỷ lệ (%)
0 Version có TeX đã xác minh 38554 41498 92.91
1 Version xác minh hợp lệ (gồm empty PDF-only/no... 41487 41498 99.97
2 Paper đủ 100% version nguồn xác minh 24997 25000 99.99
3 Paper có kết quả S2 (success hoặc empty xác nhận) 24277 25000 97.11
4 Paper đủ cả nguồn xác minh lẫn S2 24277 25000 97.11
../_images/3bcbf59af0dc9a338b3938825953346a4084e1c00df8b2cb7371e397c1f59848.png

Tài liệu và mã nguồn tham chiếu#