Milestone 2: Phân tích cấu trúc, chuẩn hóa và khử trùng (25.000 bài)#
Kết quả toàn nhóm trên Google Colab CPU-only#
Toàn bộ 25.000 bài báo / 41.498 version của 5 thành viên đã được chạy parser cold (0 reuse, code_hash=cf2de7a143c8...) qua 5 phiên Google Colab CPU-only tuần tự, sau đó gộp và kiểm chuẩn 5 bảng bằng m2_team_consolidator.py.
Toàn nhóm (5 thành viên): 25,000 paper / 41,498 version | Cập nhật: 2026-11-22
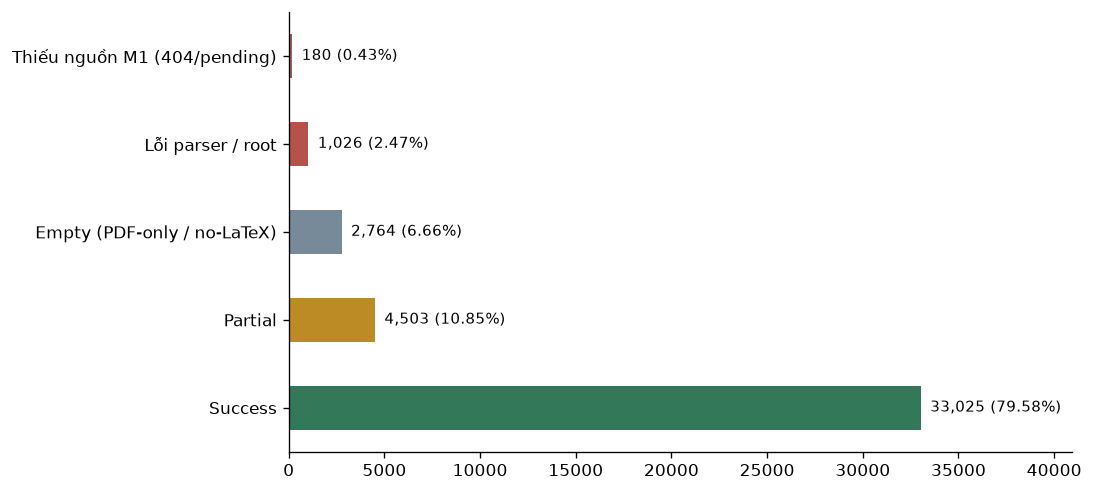
Bảng M2.1. Phân bố trạng thái parser trên 41.498 version.
| Trạng thái | Số version | Tỷ lệ (%) | |
|---|---|---|---|
| 0 | Success | 33025 | 79.58 |
| 1 | Partial | 4503 | 10.85 |
| 2 | Empty (PDF-only / no-LaTeX) | 2764 | 6.66 |
| 3 | Lỗi parser / root | 1026 | 2.47 |
| 4 | Thiếu nguồn M1 (404/pending) | 180 | 0.43 |
Bảng M2.2. Kết quả và hiệu năng M2 theo từng thành viên (Colab CPU-only).
| member | id_range | publications | versions | success | partial | empty_no_tex | error | tex_success_rate | tex_parsed_rate | runtime_sec | avg_sec_per_pub | peak_rss_mib | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | DAT | 2412.18848 - 2501.02641 | 5000 | 8149 | 6470 | 853 | 621 | 156 | 86.51 | 97.91 | 3350.243 | 0.670049 | 845.34 |
| 1 | TUAN | 2502.03235 - 2502.08234 | 5000 | 8550 | 6782 | 990 | 505 | 220 | 84.86 | 97.25 | 3777.627 | 0.755525 | 789.36 |
| 2 | TAN | 2407.12839 - 2407.17838 | 5000 | 8093 | 6420 | 876 | 588 | 192 | 85.74 | 97.44 | 3740.636 | 0.748127 | 498.27 |
| 3 | TRI | 2406.17938 - 2407.02838 | 5000 | 8338 | 6668 | 893 | 493 | 257 | 85.29 | 96.71 | 3924.095 | 0.784819 | 512.07 |
| 4 | TRIET | 2406.12938 - 2406.17937 | 5000 | 8368 | 6685 | 891 | 557 | 201 | 85.96 | 97.42 | 3899.487 | 0.779897 | 546.96 |
Bảng M2.3. Khử trùng toàn bộ 25.000 bài sau chuẩn hóa.
| before | after | reduction_rate | removed | |
|---|---|---|---|---|
| elements | 23099589.0 | 15006000.0 | 0.350378 | 8093589.0 |
| bibtex | 1834650.0 | 1177293.0 | 0.358301 | 657357.0 |
Tài liệu và mã nguồn tham chiếu#
Mã nguồn triển khai: src/parser/main.py.
Mã nguồn triển khai: src/parser/statistics.py.
Mã nguồn triển khai: tools/m2_colab_runner.py.
Mã nguồn triển khai: tools/m2_team_consolidator.py.